当自动驾驶行为出乎意料,解释能帮人预判什么
一项真实车辆与在线录像研究显示,概念解释能改善人对车辆行为的理解和预测;但可理解不等于更安全,更不是事故减少的证据。
当自动驾驶行为出乎意料,解释能帮人预判什么
一辆自动驾驶测试车驶近上下客区,忽然停住。安全驾驶员以为,车是因为上下客区域才停车。车载界面给出的解释却指向另一件事:规划器认为自己“离另一辆车太近”。后续观察支持了这个解释——相关概念的激活与车辆启停相伴变化。
这是2026年9月2日发表于《自然》的一项研究中的真实测试场景。需要立刻补上一处限定:这个“靠近车辆”案例采用的是研究团队另行开发的并行、事后解释架构,并非论文主推的因果架构;作者也明确承认,它可能较不忠实。这个细节重要,因为整项研究最想回答的,恰恰不是汽车能否给出一句听起来合理的话,而是显示出来的理由是否真的参与了决策。
研究团队提出“概念包装网络”CW-Net,把难以读懂的深度神经网络规划器,连接到“接近停止车辆”“靠近骑行者”“离其他车辆过近”等人类概念。它关注一个具体问题:当机器暴露自己的判断依据,人能否形成更准确的“心智模型”——更清楚地知道这辆车在什么情况下会怎样行动,又可能在哪里犯错?
论文给出的答案是,在它测试的特定情境中,可以。可是,这个答案不能被改写成“可解释AI减少事故”。研究没有测量事故率,也没有证明解释必然转化为更安全的道路结局。
让概念进入决策链
许多解释方法是在模型作出决定之后,再用另一套方法说明“哪些因素可能重要”。它们可能有用,却留下一个根本疑问:解释讲的是模型真正采用的理由,还是只生成了一段与结果相符的说明?
CW-Net的主要架构试图缩小这道裂缝。研究者保留预训练规划器的大部分结构,把最后的奖励层替换成概念分类器,再接一个新奖励层。候选轨迹最终得到多高分,只由概念分配决定。解释界面展示的概念不再只是旁观者,而是最终决策模块的输入。作者因此把主架构称为“因果忠实”的解释。
这可以与美国国家标准与技术研究院NIST提出的四项可解释AI原则对照。第一,系统应为输出或过程提供证据或理由;第二,解释要能被目标使用者理解;第三,解释要准确反映系统产生输出的理由或过程;第四,系统应只在设计条件之内、并在置信度足够时运行。
按这个框架看,CW-Net的长处,是把“有解释”“人能理解”和“解释忠实”放到同一项研究里。但这种对应是本文的分析,不是NIST认证。它也没有完整解决第四项“知识边界”:显示某个概念没有被激活,不等于系统会在能力不足时自动拒绝行动。
车内试验揭示的是意外,而非完美
私人测试场里,研究人员没有预先编排每一个故障,而是在高层测试计划下观察自然出现的意外行为。除了靠近停放车辆时停车,测试车还曾在一个交通锥附近制动。解释表明,“接近停止车辆”概念在停车前升高;进一步测试支持了规划器在这里错误匹配了一个并不存在的停止车辆。
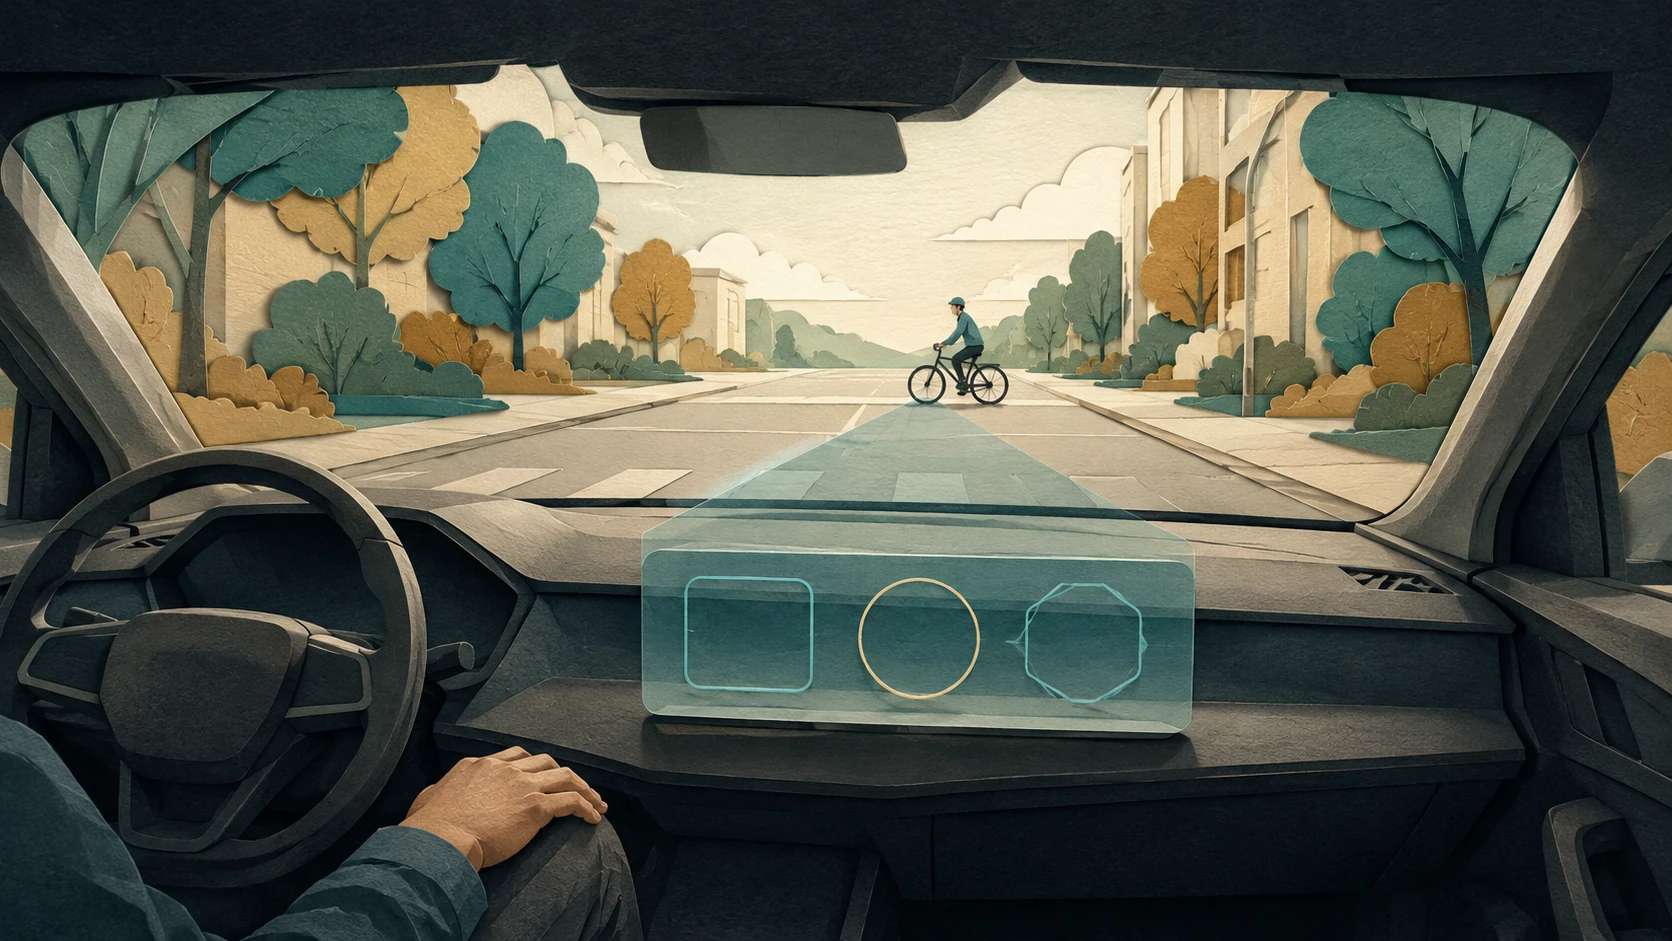
第三个情境更能说明解释与安全结果不能混为一谈。测试车多次在骑行者前安全停下,但“靠近骑行者”概念始终低于1%。驾驶员看到这一点后变得谨慎,以更低速度启用自动驾驶。事后分析发现,感知系统虽然看到了骑行者,机器学习规划器却没有被配置为接收骑行者输入;车辆实际停车,靠的是另一个独立的紧急制动备份系统。
这不是“解释让车刹住了”,而是解释让人发现:表面正确的停车结果,掩盖了规划器内部的缺口。它改善的是人对系统的判断,安全停车本身来自安全冗余。两者必须分开。
车内部分也不应被包装成百人大试验。论文描述了安全驾驶员、支持工程师和研究员在场,并以三个事件展示驾驶员解释前后的想法与反事实预测,但公开正文没有清楚报告这部分安全驾驶员总人数。图中的数千个观测值、50次概念尖峰和23次骑行者测试,是观测或测试次数,不是受试者人数。
真正的“100人”,是在网上看录像
研究的百人规模来自另一项实验。团队先在拉斯维加斯公共道路收集素材:出于安全考虑,测试车由安全驾驶员手动驾驶,CW-Net只在后台运行。研究者从真实道路记录中选取六段“惊讶”事件、六段常规事件,再加一段注意力检查视频,让美国成年参与者在线作答。
参与者被分为两组。一组看到CW-Net概念解释,另一组看到速度和方向盘信息,以平衡额外信息带来的认知负担。目标样本为100人,经注意力和观看时长检查后,最终分析99人:解释组51人,对照组48人。视频暂停后,他们回答关于感知、理解与未来行为投射的问题。
在惊讶事件里,解释组表现更好:感知的效应量Cohen’s d为1.290,理解为0.996,投射——也就是对接下来会怎样的预测——为0.606。前两项是较大效应,投射为中等效应。常规事件经Bonferroni校正后未检出显著组间差异;不能据此证明解释无害或与对照等效。
这个结果支持一个克制但有价值的结论:当车辆行为偏离直觉时,概念解释能帮助观看者更好地识别系统输入、理解行为理由,并预测其后续行动。
但这100人没有坐进车里,也没有在高速变化的驾驶环境中接管车辆。他们看的是经过选取的录像,回答的是二元问题。公共道路素材采集时,实验规划器并未控制车辆。因此,这项实验不能回答解释是否缩短接管时间、降低碰撞概率或减少伤亡。
另一项39人实验,以及测量的边界
研究团队还请9名Motional安全驾驶员和工程人员、30名在线非专家观看私人测试场的三个事件。他们先在没有解释时判断车辆为何行动并预测反事实结果,随后观看带解释的同一录像,再次作答。9名专家中有8名、30名非专家中有27名的最近邻信念指标改善;心智模型改善也与预测表现改善相关。
不过,这是一种固定顺序的组内前后测,没有同期“始终无解释”的平行组,不能完全排除重复观看、学习或实验意图的影响。自由文本由GPT-5担任评判者;研究者用专家回答调试提示三轮,再一次性用于非专家回答。专家样本很小,而且来自参与研究的公司。这些限制不抹去结果,却决定了结果能被推广多远。
最值得报道的,也许是解释暴露失败
CW-Net并没有整齐漂亮的概念识别成绩。在留出数据上,概念分类平均准确率为54%,精确率23%,召回率77%,F1仅0.31;“慢速”概念F1达到0.82,“靠近骑行者”却接近零。研究者把这种不均衡视为一种信息:解释不仅呈现系统知道什么,也可能揭示系统没有学会什么。
这或许是研究最值得延展的地方。可解释性的价值未必是给每个决定配一句安抚人的话,而是帮助操作者校准信任。人不再因为车在一次测试中停住,就误以为规划器理解了骑行者;也不会把一次莫名制动简单归因于肉眼可见的物体。好的解释既帮助人预测机器,也帮助人识别不能依赖机器的时刻。
研究仍有明确边界。它集中于一种分类式规划器和有限概念集;真实部署的CLOSE案例使用了忠实度较弱的事后架构;真实车辆模型权重和训练代码受Motional知识产权限制而未公开。利益冲突声明显示,7名作者研究期间受雇于Motional,第一作者在数据收集阶段作为研究实习生获得报酬,部分作者可能持有公司权益。图表代码、部分数据以及玩具域复现版本则已公开。
“更会预测”究竟测到了什么
心智模型不是一张可以直接拍摄的脑内地图,研究者只能通过任务表现间接测量它。论文采用了三种相互补充的办法:让参与者选择车辆行为的最近理由,让他们写下自己的解释,再让他们判断条件改变后车辆会怎样行动。前两种更接近“你认为系统为什么这样做”,后一种则追问“你的理解能不能支持下一步预测”。把解释前后的变化联系起来,是这项工作的实验亮点。
同时,读者应当区分统计相关与因果链条。在39人实验中,心智模型指标改善与预测改善相关,说明两者同向变化;但固定顺序前后测不能单独证明,只有解释内容造成了全部变化。99人SAGAT实验设置了解释与占位信息对照,更适合判断组间差异,却仍然测量观看录像后的回答,而不是道路上的身体动作。两项实验互相补强,却没有把证据延伸到刹车踏板、接管延迟或碰撞结局。
“惊讶事件”也是理解结果的关键词。解释在常规驾驶片段中没有检出显著组间差异,在偏离直觉的片段中效应更明显。这符合解释研究的一种基本直觉:当系统行为与人的预期一致,额外信息的边际价值较小;当二者冲突,揭示机器内部分类才可能重写人的判断。然而,论文使用的是研究者选出的特定概念和事件,尚不能保证这种优势覆盖夜间、恶劣天气、复杂路权或从未标注的新型危险。
因此,“人更懂车”也要拆开说。参与者可能更准确地认出了系统当时采用的理由,但这个理由本身仍可能是错的;交通锥附近那次制动就是典型例子。解释准确反映错误推理,与推理正确,是两个不同命题。前者能帮助操作者预判机器,后者才直接涉及机器是否作出合适行动。安全关键系统需要两者,也需要独立制动、故障检测、运行边界和责任制度共同兜底。
来源与边界
主要事实、样本、效应量和利益冲突来自《自然》论文及其Methods、Ethics declarations、Data availability和Code availability。解释AI的四原则来自独立主体NIST的NISTIR 8312。NIST明确说明,可解释性只是可信AI多个属性之一;准确、可靠、鲁棒、安全、公平与问责不能由“解释得清楚”替代。
本文没有把心智模型改善外推为事故减少,也没有把在线录像实验写成车内道路试验。研究建立的证据链是:概念进入主架构的决策过程;人在特定惊讶场景中读懂部分概念;他们对系统行为的预测随之改善。它尚未证明这种改善能在真实驾驶压力下带来更快、更正确的接管。
回到那位面对骑行者的安全驾驶员:车已经停住,界面却告诉他,规划器并没有真正“看懂”眼前的人。此时解释的意义,不是替机器宣布安全,而是让操作者知道自己仍须谨慎,并看见最后托住车辆的其实是另一道安全防线。